Ascend Dispatch Profiling
先把三层问题分开
领导说“看看 icache miss”,可以理解为提出了一个值得验证的瓶颈假设。真正需要回答的是:dispatch 花了多少时间,其中有多少可能与取指有关,改动后真实多卡延迟是否下降。
ICache 是 Instruction Cache,指令缓存:核要先取得指令,才能执行数据搬运、地址计算或分支。代码工作集较大、频繁切换执行路径等情况可能增加取指开销,但通信 kernel 也可能只是一直等其他 rank。看到耗时长,不能直接把原因归给缓存。
这里要逐层使用三个工具入口:
- **系统级
msprof**记录应用下发、stream 上的任务和设备执行时间。它回答“哪个 rank、哪个 kernel、哪一段调用慢”。 - **算子级
msopprof**采集具体 kernel 的硬件指标或指令信息。旧资料常写作msprof op;在新版环境先检查两个命令的--help,使用实际安装的入口。它回答“核内时间花在哪里”。 - MindStudio Insight读取采集文件并展示时间线、源码和详情。它不会替已有文件补采 ICache、PC 或调用栈;采集时没开、芯片不支持或调用场景不兼容,界面里就没有相应证据。
系统工具的基本调用来自官方快速入门;本文单算子选项依据 Ascend/msopprof 固定版本 1f80e624,该提交时间为 2026-09-15。这不是对你机器上“最新 CANN”具体版本的猜测:部署包、工具和配套文档仍须现场核对。
下面这张图用于区分采集顺序,以及真实运行和仿真各自能说明什么。
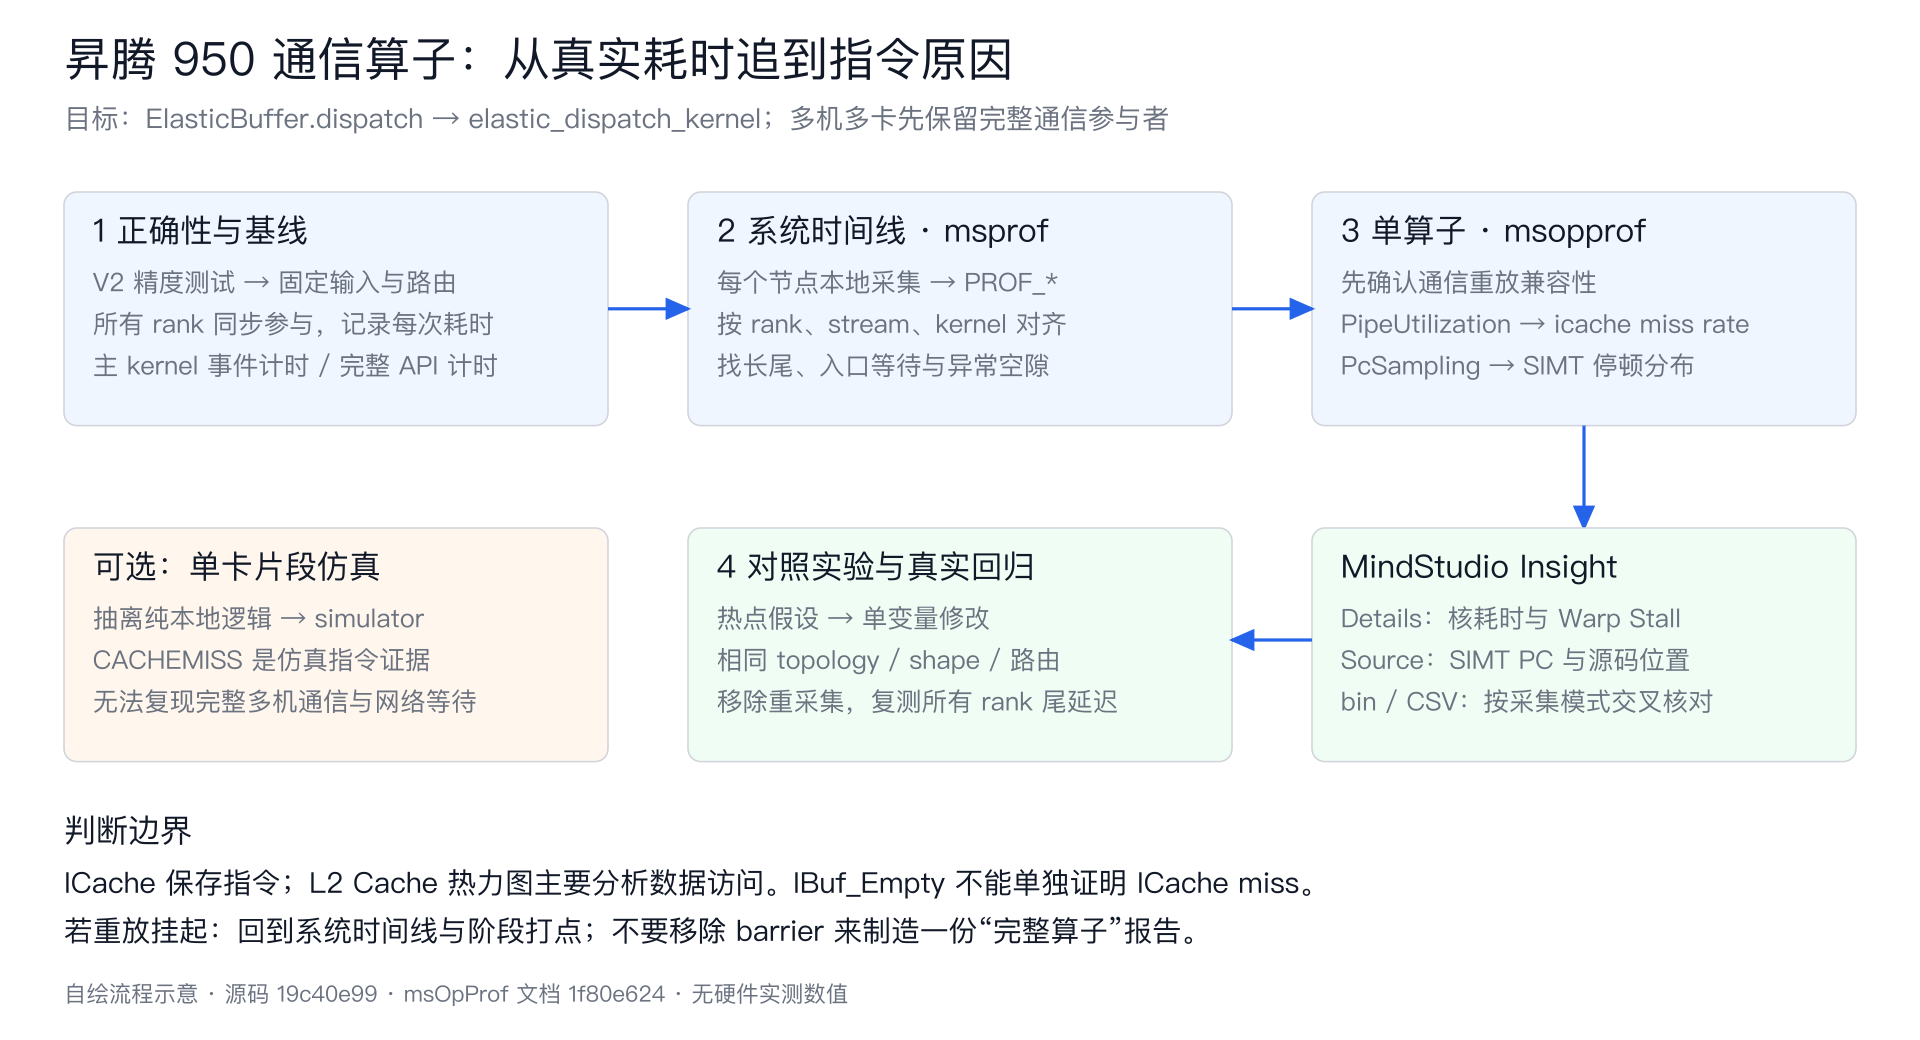
自绘流程示意。算子源码固定为 19c40e99,工具文档固定为 1f80e624。先得到真实多卡基线,再检查硬件指标;单卡片段仿真位于旁路,不代表完整通信性能。
确认测到的是目标算子
固定源码和调用入口
本文读取的 deepep_ccd 分支提交是 **19c40e99a622c2778c4c5ce94aa1f6adc33effbc**。后续讨论均以这个版本为准,不能套用仓库其他分支的实现。
目标调用链是:
1 | V2 测试:test/test_v2_elastic_dispatch_precision.py |
真实测试调用位于精度测试第 686–697 行:
1 | dispatch_args = dict( |
第一次建议使用 BF16,此时 x_scales 为 None。输入 x 为每 rank 的 [T, H] token 特征;topk_idx 和 topk_weights 为 [T, K] 专家编号和权重;num_sms 在这个接口中控制 AIV 数量。AIV 是 AI Vector Core,rank 是分布式进程,两者不是一回事。
输出按本地专家展开接收数据。该版本的 recv_topk_idx 表示展开行对应的 top-k 槽位,不能按输入的全局专家编号解释。测试还明确说明 FP8 路径没有传输和返回完整 scales;因此先用 BF16 建立基线,避免把数据类型语义问题混入性能问题。
这一差异可对照 V1 launcher 第 109–112 行和 V2 host 入口第 2831–2894 行。
先知道 kernel 在做什么
从 profiling 角度,不必一开始理解全部通信协议,但要知道不同核的职责。目标源码的 Process() 第 2508–2536 行按 aivId_ 分工:
- 前一组 AIV 执行
TokenCopyToBuffer(),准备发送缓冲,并发布阶段完成标志。 - 后一组执行
URMASendToken(),组织远端传输。 - 另一组执行
SelfCopyToken(),处理本地数据。 - 剩余核执行
CalCumSum(),处理计数和前缀信息。 - 随后进入
LocalWindowCopy(),整理本地输出。
原始 token、路由和输出位于各 rank 的设备内存;远端传输移动 token 数据,路由到多个专家时可能形成多条输出。通信缓冲和完成标志由参与 rank 协同维护,不能把它当成完全独立、可任意重复调用的单卡计算核。源码依据
此外,elastic_dispatch_kernel 入口第 2706 行直接调用 aclshmemx_barrier_all_vec();发送路径存在 WaitAllStageDone(),SIMT 路径存在 ThreadBarrier()。SIMT 是 Single Instruction, Multiple Threads,单指令多线程执行;源码用 AscendC::Simt::VF_CALL 启动这些片段。
这带来两个实际判断:耗时最长的核可能在等同伴;不同核职责不同,本来就不一定等负载。 即使 Occupancy/核间负载视图给出不均衡提示,也必须先按职责分组,再比较同类核。发送与 SIMT 源码
第一步:跑通并保存基线
记录环境和编译条件
采集在 Linux 昇腾服务器上执行;Mac 用于阅读数据。每个节点保存以下信息,不能只写“最新”:
1 | npu-smi info |
其中 msopprof 和 msprof op 可能只有一个入口可用;单个探测失败不代表算子失败。另行保存 CANN、驱动、固件和 MindStudio Insight 的完整版本、NPU 型号细分、节点/卡/端口拓扑、编译命令和源码提交。950 文档经常明确写 950PR/950DT,应与现场型号核对。
需要源码映射时,为设备 kernel 的编译目标添加 -g,保留用于基线的优化级别。当前仓库 cmake/AscendDeepEPKernel.cmake 第 272–278 行明确使用 -O2;不能只给 Python 扩展的 host C++ 加调试信息,也不应把整个工程改成 -O0 再判断发布版本瓶颈。保留本次编译出的 .so/设备二进制及对应源码。源码
-g 用于地址到源码的映射,不等于已经启用了全部指令采集。正式基线也应记录 ASCEND_DEEPEP_DEBUG_CLOCK / DEBUG_CLOCK_ON 等打点开关,避免把频繁导出 CSV 的开销当成 kernel 开销。
先用 V2 精度测试验证全链路
以下是 2 节点 × 每节点 8 卡的模板。IP 使用文档示例地址,运行前替换为节点 0 实际可达地址。各节点执行相同命令,仅 RANK 分别取 0、1;沿用仓库要求让节点 0 先启动,确保 SHMEM store 可连接。
1 | # 在每个节点的 ascend_deepep 仓库根目录执行。 |
这组 shape 和 AIV 数参考仓库多机启动脚本,只是起点,不是 950 的通用最优参数。需满足现场设备可见范围、可用 AIV 数及实现约束。专家数必须能被全局 EP rank 数整除。
这里有一个特殊约定:父进程环境中的 WORLD_SIZE 是节点数,RANK 是节点编号,--ep-size 是每节点进程数。 脚本内部再 spawn 各卡进程,形成全局 EP16。不要再外套 torchrun --nproc-per-node=8,否则会重复创建进程。这个约定来自该仓库,不是一般 PyTorch 分布式变量的通用含义。官方项目启动脚本
判断成功要看所有 rank 的精度检查和退出状态。这个测试包含数据生成、参考计算与 HCCL all-gather,整个进程运行时间不是 dispatch 延迟。
用现有计时接口补上重复测量
该分支已经提供 ElasticBuffer.profile_dispatch_latency():它在主 kernel 的通信 stream 上记录事件,最终由全局 rank 0 写出 dispatch_latency.csv。比在 Python 默认 stream 上随手放一对事件更贴近目标核,因为 ElasticBuffer.dispatch 内部使用专用通信 stream。Python 接口、CSV 实现
可以复制 V2 精度脚本作为本地性能驱动,将第 694–697 行的单次调用替换为下面的片段,保留初始化、输入构造、最后一次结果的精度检查及销毁流程。buffer 和 dispatch_args 均来自前面的真实测试代码;这不是一个可脱离上下文独立执行的程序。
1 | with buffer.profile_dispatch_latency( |
所有 rank 都要进入上下文,并执行相同次数。 warmup=10 只将前 10 个样本标为预热,不会替你调用 10 次;这里实际执行 110 次,余下 100 次用于统计。每次同步形成隔离延迟测量,会改变真实业务中的并发重叠,报告中应明确这一点。
synchronize_start=True 还会在主核计时前插入一个不计时的 SHMEM barrier,以减小启动偏斜;主 kernel 自己的入口 barrier 仍在计时内。该结果是 主 kernel 事件区间,不包含完整 Python API、所有内存分配和其他辅助 kernel。完整 dispatch API 延迟应另行计时,并等待通信实际完成,分别报告两种口径。计时插入位置
建议保留逐次、逐 rank 原始值。先对每次迭代取各 rank 的最大耗时,再计算这些最大值的中位数和 P95;同时报告各 rank 分布。“各 rank 的 P95 再取最大值”与“每轮最大值的 P95”并非同一统计量。 百次样本适合起步,尾延迟不稳定时增加样本和独立复跑。
第二步:用 msprof 找到慢在哪里
先采一轮系统时间线,不开全套重指标。将上面的 V2 测试命令连同同样的 shape 写入每个节点本地的 run_v2_probe.sh,脚本中加载实际 CANN/SHMEM 环境并进入仓库目录;保留父进程 WORLD_SIZE、RANK 等变量。
1 | # 每个节点分别执行;prof_root 可改为该用户有写权限的真实目录。 |
这个脚本应运行 V2 精度测试或已验证的短驱动,不是 bench_ep.py,也不是负责 SSH 扇出其他节点的总控脚本。仅用 msprof 包住本机 SSH launcher,不能据此声称已采到远端各节点的数据。先确认 spawn 出来的各 NPU 进程都有数据;缺失时再依本版本采集说明调整进程内采集,而不是在同一设备叠加多个 profiler。
默认系统时间线是否足够、是否需要显式开启 --task-time / AI Core 指标,以现场 msprof --help 为准。旧资料中的 --hccl=on 已有弃用提示,不宜无条件照搬。系统级 --aic-metrics 和算子级同名参数也有不同可选值,不要混抄两个命令的选项。系统采集参数说明
正常结束后应产生 PROF_* 目录。检查日志确认解析和导出成功;如未自动导出,按现场版本执行独立解析/导出流程。保留完整目录以及 hostname、node rank、global rank、device id、PID 的映射,不要只拷走一张截图。
在 Insight 系统时间线中依次检查:
- 找实际 kernel 名:搜索
elastic_dispatch_kernel,记录完整名称、stream、task 标识及调用序号。 - 看整个调用链:确认是否还有 layout、notify 或 epilogue。当前源码里其中几个入口是占位实现,不能按名字脑补其占比。
- 对比每个 rank 的时间与重复次数:谁持续最慢,还是偶尔某个 rank 变慢;是否采到了相同迭代。
- 区分下发空隙与 kernel 执行:空隙可能来自 CPU 调度、同步或准备数据;kernel 内部的等待则会计入执行时间。
- 校验时钟对齐:跨节点绝对时间不能仅凭文件时间戳直接比较;用工具支持的对齐方式或同一迭代的相对区间分析。
第三步:采集真实 ICache 指标
先确认重放边界
硬件性能计数器 PMU(Performance Monitoring Unit)同时能观测的事件有限。算子调优工具通过重放等机制获取不同组指标。当前文档规定,默认 --replay-mode=kernel 会多次执行单个 kernel;application 是整个应用重放,但 多卡多算子场景不支持 application 模式;kernel/range 模式还会清理 L2 Cache。
对于纯本地加法,多执行几遍通常很好理解。对于这个 dispatch,某个 rank 重放 barrier、远端标志或发送队列,而另一端已经进入下一阶段,就可能挂起或改变语义。这是根据源码通信依赖推导的风险,不是本次已经复现的工具缺陷。 官方列出的 MC2/LCCL 支持,也不能直接证明任意 SHMEM/URMA 自定义 kernel 兼容。重放模式与支持边界
因此先用最小但有效的多机配置做探测:保持全部通信参与者,只采一个匹配的 kernel,核对所有 rank 退出、结果仍正确、输出覆盖目标设备。必要时向工具维护方确认该启动方式、通信类型和重放支持。不要删除 barrier、只启动一个参与者,或者依赖单 rank 提前退出来“解决”采集问题。
从 PipeUtilization 开始
在所有节点使用同一个、只调用短测试的 run_v2_probe.sh,下面两种入口择其一:
1 | # 新版入口;仅在本版本支持该调用场景、重放验证通过后使用。 |
--warm-up=0 是首轮减少工具额外预热调用的选择,不会关闭指标重放;它也不保证冷启动时间可作为稳态性能。--launch-count=1 控制采集数量,不代表只执行一次 kernel,也不会自动让应用立刻退出。多进程的计数范围和实际覆盖必须检查产物。不要在通信探测时加 --kill=on。
精确过滤名称应来自第二步时间线。此工具默认只采第一个算子,若不设置过滤,可能拿到初始化、随机数或拷贝核。后续需要略过 warmup 时,再核对 --launch-skip-before-match 的计数语义:它按匹配前所有调度算子计数,不能直接把业务迭代数填进去。参数依据
采集成功后,在 OPPROF_* 中寻找 PipeUtilization.csv 或带时间后缀的同类文件。官方性能数据说明对 950PR/950DT 明确列出了:
| 观察对象 | 字段或信息 | 如何使用 |
|---|---|---|
| 实际核身份 | block_id、sub_block_id |
按核职责分组,保留逻辑/物理核映射 |
| AIV 耗时 | aiv_time(us)、aiv_total_cycles |
找持续拖慢阶段的核 |
| 指令缓存 | ai*_icache_miss_rate |
ai* 展开为 AIC/AIV;本核优先看实际输出的 AIV 列 |
| 向量与搬运 | aiv_vec_ratio、MTE 相关字段 |
判断核是否忙于计算或搬运,结合等待路径解释 |
ai*_icache_miss_rate 是指令缓存缺失率,不是 Insight Cache 页里的 L2 数据缓存命中率。950 字段表
不要照搬旧 A2/A3 的 scalar_wait_ib_time 等字段,950 的字段表并不完全一致。缺失列应记录为“不提供/未采到”,不能填 0;百分比单位和归一化方式以该版本实际输出说明为准。不同 Pipe 可并行,不能把各 Pipe 时间相加当成 kernel 总时长。
没有一个对所有 kernel 都有效的“miss 超过多少就是瓶颈”阈值。 高 miss rate 只是一条线索,还要看绝对耗时、热点区域及对照改动。一个很短的冷启动核可以有较高 miss,长时间轮询也可能热在 ICache 中却持续很慢。
第四步:在 950 上追到 SIMT 和源码
用 PC 采样解释停顿
950 的一个有用增量是 PcSampling,它采样 SIMT 指令位置及停顿原因。PC 是 Program Counter,指令地址;采样帮助把等待集中到某段程序,而不是只得到整个核的一个比例。
在重放兼容性已经确认、kernel 编译带有 -g 的前提下,独立进行一轮采集:
1 | msopprof \ |
这是单独一轮,不与系统 msprof 在同一设备同时运行。若组合选项不被现场版本接受,按对应版本文档分开采集。PcSampling 的支持对象是 SIMT,不能期待它完整解释外层 AIV 标量控制、全部搬运和远端等待。官方 950 停顿采样说明
将生成的 visualize_data.bin 导入 Insight,先在 Details 看 Warp Stall,再到 Source 选择对应 Core 和源文件,检查 SIMT PC 附近的指令与源码:
IBuf_Empty:指令缓冲为空,指令供给可能有问题;不能单独等同 ICache miss。- **
Scoreboard_Not_Ready**:依赖尚未就绪,应结合前序访问与指令依赖分析。 - **
Warp_Level_Sync**:warp 级同步等待,需检查线程间工作与同步安排。 - **
Register_bank_conflict/Resource_conflict**:寄存器 bank 或资源冲突,属于另一类原因。 - **
active**:成功发射样本;解释比例时区分All Samples和不含 active 的Not Issue,不要混用分母。
这些是采样统计,不能把样本数直接乘一个固定周期,就宣称得到全部停顿时间。最好同时查看绝对 kernel 时间、ICache 指标和源码变化。
源码中值得按实际热点核对的候选包括 simt_prepare_mapping、buildRemoteWqeDesc、simt_nw_mj_vf 与 simt_write_wqe_v4。它们是排查对象,不是本次确认的性能瓶颈;WaitAllStageDone 等通信/阶段等待则要从相应控制路径看,不能指望 SIMT 采样覆盖一切。
指令流水与仿真怎么选
需要观察搬运和执行重叠时,950 还提供 PipeTimeline 和 InstrTimeline。前者看 Pipe 区间,后者看所支持 Pipe 的指令耗时,分别独立采集;二者不能同时开启。例如把上一条命令的指标替换为:
1 | --aic-metrics=PipeTimeline |
或:
1 | --aic-metrics=InstrTimeline --instr-timeline-pipe="mte2|mte3|vector" |
官方支持列表主要是 Cube、FIXP、VECTOR 和 MTE 等通路,不能把 InstrTimeline 理解为全部 SIMT 指令的停顿分类。当前文档还说明这两项暂不支持通算融合类算子。目标代码有自定义通信,需要确认工具分类和启动路径;不能因为跑在 950 上就认定可用。TimelineDetail 则是包含仿真细节的另一种模式,对 PyTorch 单算子 API 调用、二级指针和通算融合也有限制;目标源码是 <<<...>>> kernel 直调,不宜把 TimelineDetail 作为默认方案。支持条件
旧教程中的 msprof op simulator / 新入口 msopprof simulator 会产生仿真指令流水,其中 CACHEMISS 表示 ICache miss。但当前官方文档仍写明:只支持单卡,无法仿真多卡环境,且不支持 MC2/HCCL 类型算子。 目标完整 dispatch 依赖多 rank barrier 和远端数据,即使工具没把它标为 MC2,也不能假定单卡仿真能执行完整路径。仿真约束与 CACHEMISS 定义
如果上板证据指向本地描述符构建,可抽取该纯本地片段,固定输入并制作独立程序,再用:
1 | # 先设置为安装包支持的精确 SoC 名称;不要把市场型号“950”直接填入。 |
local_mapping_probe 是需要另外开发的本地片段程序,不是仓库已提供的二进制。抽取改变了代码布局、指令工作集和并发背景,只能验证局部假设;结果最终必须回到真实多机 dispatch 验证。不要无条件套用旧教程的 PMSampling / Overhead,当前仿真文档明确它们不支持 950。
第五步:在 Mac 上看数据并形成判断
MindStudio Insight 26.1.0 官方安装说明提供 macOS Apple Silicon 和 Intel 包,可在服务器采集后把产物复制到 Mac 分析。版本应满足数据格式要求,并保留生成数据的工具版本。安装指南
不同文件的打开目标如下,先分清这一点可以少走很多弯路:
| 数据 | 进入的分析层次 | 主要问题 |
|---|---|---|
系统 PROF_* 目录及其导出文件 |
系统 Timeline | 哪个 rank/kernel 慢,任务之间是否有空隙 |
单算子 visualize_data.bin |
Details / Source / 相应 Timeline | 核指标、SIMT 停顿、指令或源码热点 |
仿真 trace.json |
指令 Timeline | 仿真 Pipe、CACHEMISS、指令依赖 |
PipeUtilization*.csv |
表格分析,与 Details 对照 | 精确核级指标及跨运行比较 |
dispatch_latency.csv |
本地统计 | 无重 profiler 的主 kernel 延迟基线 |
Insight 会根据 bin 中已有数据展示页面;一个 bin 不必然包含所有功能。当前官方指南要求 bin 单文件导入,仿真 JSON 需要工具生成的算子标识。保留产物目录结构、源码及二进制,不要靠手改 JSON 字段伪装文件类型。Insight 算子调优指南
一次实际分析可以按下面的证据链进行:
- 系统时间线确认 rank 7 的目标核持续较慢。
- 根据源码的核分工,确定慢的是发送核还是输出整理核。
- 若该组 AIV 的 ICache miss 偏高,再查对应 SIMT 片段是否出现指令供给相关停顿。
- 对热点路径做一个有针对性的改动,例如减少经反汇编确认的大量展开或过度内联,保持输入和路由相同。
- 确认源码/指令证据与预测一致,再关闭重采集,复测完整多卡延迟及精度。
这只是分析示例,不是真实 rank 7 的实验结果。如果实际看到的是大段等待标志或同步,就应转向发送完成、负载偏斜、队列/链路或阶段依赖,不能为了得到 icache 结论而忽略其他证据。减少展开/内联还可能增加循环、调用和调度开销,所以“代码变小”本身也不是收益证明。
如果完整算子的重放采集挂起,可靠的退路是:保留 msprof 系统时间线,使用现有 DebugClock 机制按核职责定位等待阶段,抽取本地片段做指令分析,并将完整 kernel 的 PMU 兼容性标记为未解决。源码已有 DebugClock(1/4/5/6/7) 等阶段位置,但不同核走不同分支,编号间隔并非天然可横向等同比较;跨设备 cycle 也不能当成一个全局时钟。
最后交付什么
建议给负责人一份能复现结论的短报告,而不只是 Insight 截图:
- 环境与输入:精确软硬件版本、源码 commit、编译选项、节点×卡数、transport、AIV 数、
T/H/K/E、dtype、路由和 seed。 - 性能基线:主 kernel 与完整 API 两种口径;预热、样本数、同步策略;逐 rank 分布和每轮最大值的中位数/P95;profiler 开销另列。
- 定位证据:系统 timeline 中的 kernel/rank/task、实际 ICache 字段、SIMT 停顿、源码位置;说明哪些来自真实上板、哪些来自仿真。
- 对照结果:只改一个主要因素,重复运行,记录精度、主 kernel、完整调用和尾延迟是否同向改善。
- 未决边界:工具不支持的模式、缺失指标、通信重放是否验证、网络证据是否齐全。
若报告带宽,必须先定义字节量:是有效跨 rank token 字节、包含 top-k 复制的逻辑输出字节,还是物理链路字节;是否包含元数据、本地流量和协议开销。用分配的输出容量除以耗时,不能直接得到真实网络带宽。
第一轮工作的合理终点是:准确测到 V2 主核,得到可重复的多机延迟,能解释 ICache 指标从哪里来,并知道缺什么证据。到那时,是否优先优化 icache 就有了依据,而不是从一个工具选项出发猜瓶颈。
参考资料
- 目标 elastic_dispatch 源码,固定提交
19c40e99:V2 主核、分工、SIMT 与等待点。 - msOpProf 上板用户指南,固定提交
1f80e624:采集入口、重放、Source、PcSampling、Pipe/InstrTimeline。 - msOpProf 性能数据说明,同一固定提交:950 PipeUtilization 与 ICache 缺失率。
- msOpProf 仿真指南,同一固定提交:单卡边界、CACHEMISS 与 950 参数差异。
- MindStudio Insight 算子调优指南:导入格式、Source、Details、Warp Stall。master 会变化,本文保存了访问时资料。